Hi, I’m Mehdi Fekih
I am a Data Scientist. Data Engineer. Developer. Home Automation Specialist.My Blog
Mon homelab, en pratique : les grandes lignes
HOMELAB · ARCHITECTURE · SELF-HOSTING
Mon homelab, en pratique : les grandes lignes
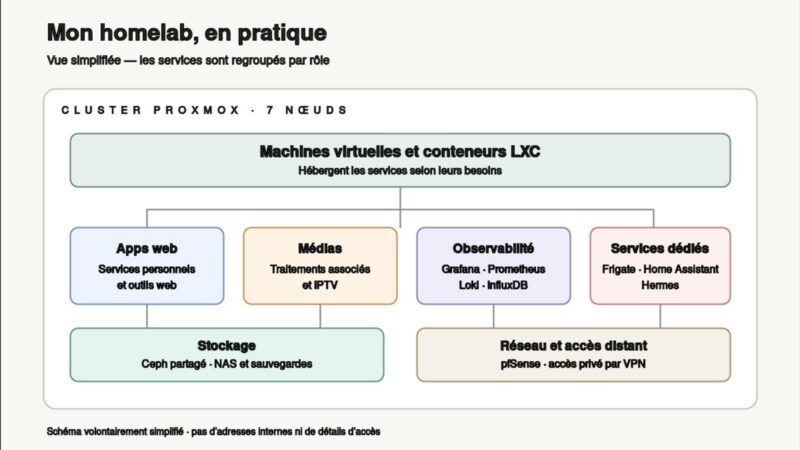
J’ai un petit cluster Proxmox qui héberge plusieurs services à la maison. Rien d’exotique : l’objectif est surtout de faire tourner des choses utiles, de savoir où elles se trouvent et de pouvoir les dépanner sans tout mélanger.
Voici le tour d’horizon. Je garderai les détails de chaque machine et service pour des billets séparés.
Proxmox en dessous, Docker au-dessus
Le cluster compte sept nœuds Proxmox. Il héberge des machines virtuelles et des conteneurs LXC, selon le besoin. Home Assistant OS a sa VM ; plusieurs serveurs Docker et Hermes tournent dans des conteneurs ; la machine qui fait tourner Frigate est une VM avec accès au matériel nécessaire.
Cette répartition évite de mettre tous les services dans le même panier. Elle ne rend pas l’ensemble magique ni automatiquement disponible en cas de panne, mais elle aide à savoir quoi redémarrer et où chercher.
Des serveurs Docker avec des rôles assez simples
Les conteneurs Docker sont répartis sur plusieurs hôtes, principalement par usage :
- applications web et services personnels ;
- médias et outils associés ;
- supervision et journaux ;
- caméras et détection avec Frigate ;
- services IPTV.
Ce n’est pas une règle absolue, juste une façon pratique de limiter les mélanges. Une mise à jour de la pile média ne devrait pas m’obliger à toucher au monitoring ou aux applications web.
Stockage : partagé ne veut pas dire sauvegardé
Ceph fournit du stockage en blocs accessible depuis plusieurs nœuds Proxmox. Un NAS sert aussi aux données de certains services et aux sauvegardes. Ce sont deux usages différents : le stockage partagé facilite l’accès aux volumes ; il ne remplace pas une sauvegarde que l’on sait restaurer.
La disponibilité dépend toujours des composants, de leur configuration et de la façon dont les pannes sont gérées. Je traiterai ces choix plus en détail dans un article dédié.
La supervision est regroupée au même endroit
Grafana, Prometheus, Loki et InfluxDB tournent sur un hôte dédié. En gros : des métriques, des tableaux de bord et des journaux regroupés pour éviter de devoir se connecter à chaque machine dès qu’un service fait des siennes.
Accès distant par VPN
pfSense gère le réseau local, le pare-feu et le DNS. Pour accéder aux services à distance, j’utilise un VPN privé. Je ne détaille pas ici les adresses internes ni les règles réseau : elles n’apportent pas grand-chose à cette présentation.
Et Hermes ?
Hermes tourne dans son propre conteneur et sert d’assistant pour différents workflows. C’est une partie plus récente de l’installation : agents, mémoire, outils et automatisations. Le point intéressant n’est pas d’ajouter de l’IA partout, mais de vérifier ce qu’un agent peut faire utilement et comment garder ses actions compréhensibles.
La suite
Cette vue d’ensemble donne les grandes lignes, sans prétendre que mon installation soit un modèle universel. Je pourrai ensuite détailler Proxmox et le stockage, la supervision, Frigate, le réseau ou Hermes — avec les choix faits, les problèmes rencontrés et ce que je changerais.
Si tu montes aussi des services chez toi, je suis toujours intéressé par les retours pratiques et les solutions simples qui tiennent dans le temps.
Two Memories, One Source of Truth: Designing a Reliable Memory Layer for AI Agents
The memory failures that hurt most in long-running agents come from bookkeeping. Nobody can say where a stored fact came from, whether it is still true, or which of two contradicting entries should win. Retrieval quality matters, but a perfect retriever over an unreliable store returns unreliable answers faster.
This article describes an architecture that keeps two memories and gives them different jobs. A human-readable Markdown knowledge base, organized like an Obsidian vault, holds durable truth. A semantic conversational memory, backed by embeddings, holds a searchable projection of that truth plus recent context. The first is canonical. The second can be deleted and rebuilt at any time.
Why one memory is never enough
A pure vector memory is convenient. The agent says something, the system embeds it, and a later similarity search brings it back. It also has no concept of a fact being replaced. Suppose a deployment preference changes in March. The January note and the March note can both sit close to the query “how do we deploy”, and the one that surfaces may depend on phrasing and chunk boundaries rather than on which is current.
A pure file-based knowledge base has the opposite profile. It is accurate, diffable and reviewable by a person, yet an agent can miss the right note when the user phrases a question in words the note never used. Each store covers the other’s weakness, provided the relationship between them is strict.
If the index and the notes disagree, the index is wrong by definition.
Two stores, two jobs
Canonical knowledge base
- Markdown files with structured frontmatter.
- Owns decisions, preferences, procedures and facts, each with a source and status.
- Written through a validated path, by people or agents.
- Versioned and backed up because losing it is real loss.
- Read by people first, agents second.
Semantic memory
- Embedded chunks of canonical notes plus recent conversation turns.
- Owns nothing durable.
- Written only by the indexer.
- Disposable: losing it costs retrieval speed until a rebuild.
- Every hit points back to a canonical note.
The mental model is a ledger and a search engine. The ledger is careful about what it accepts. The search engine is fast, approximate and disposable. Nobody audits a search engine; they audit the ledger.
Anything an agent retrieves must carry the ID of a canonical note, or be labelled as unverified conversational context. An answer built from the second kind should say so.
What a canonical note carries
Each note is a Markdown file with frontmatter and a short body. The fields that matter are a stable ID, a type such as decision or procedure, a status such as active or superseded, provenance, sensitivity, and the replacement chain.
- Provenance: who or what produced the claim, with a pointer to the evidence.
- Status: whether the note is active, disputed, draft or superseded.
- Sensitivity: metadata that can travel into retrieval filters.
- History: what the note replaces and when it changed.
The body stays plain prose, because people read it. A note a person cannot read is a note nobody will correct.
The write path
New knowledge never goes straight into the vault. It enters as a candidate and passes through a fixed sequence:
- Capture. Propose a candidate with the raw excerpt it is based on.
- Classify. Decide what it is and whether it belongs in durable memory at all.
- Filter. Redact or reject credentials, tokens and personal identifiers before persistence.
- Validate. Check schema, provenance, duplicates and conflicts.
- Commit. Write the canonical note in one reviewable operation.
- Index. Chunk, embed and upsert vectors with the note ID and content hash.
conversation / document
|
[ candidate ]
|
classify --> ephemeral --> semantic layer only
|
privacy filter --> reject / redact
|
validate --> conflict? --> review queue
|
canonical note (Markdown, versioned)
|
indexer (chunk, embed, hash)
|
semantic memory <-- query -- agent
|
hit + note ID --> agent reads canonical note
The order is deliberate. Filtering sits before validation and commit because a secret that reaches any durable store has already leaked, and embeddings are a poor place to discover that.
Provenance prevents quiet authority
A claim without a source stays in draft and is never served as fact. The source field distinguishes what a person stated, what a document says, and what the agent inferred.
This prevents a quiet failure: an agent infers a preference from one remark, stores it, and three sessions later repeats it as established. When the source is visible as an agent inference, the claim cannot be promoted without confirmation.
Validation and conflict handling
On commit, compare a candidate with active notes of the same type and subject. There are three outcomes:
- Duplicate. Merge into the existing note and update its review date.
- Extension. Create a new note that links to the old one.
- Contradiction. Do not overwrite anything. Send the candidate to review.
When a replacement is confirmed, the new note records supersedes. The old note stays on disk, changes to superseded and is excluded from the index by default. Last-write-wins destroys context; keeping both lets retrieval choose by phrasing.
Rule of thumb. An agent may add knowledge on its own authority. Replacing knowledge requires a source that outranks the original.
Privacy filtering and re-indexing
The canonical store is plain text. If sensitive content slips in, it can be found with a text search, removed, and re-indexed by note ID. Doing the same inside a vector store alone is much harder because there is no readable source to search.
Because the index is derived, rebuilding it is routine. Triggers include an embedding model change, new chunking rules, a schema change or an edit to a note. Build a full rebuild into a new index and swap it in when complete, so the agent never queries a half-built one. Keep a few regression questions with known answers to check retrieval after the swap.
Limits worth stating
The review queue can grow faster than anyone clears it. Conflict detection can miss contradictions phrased very differently. Model-based classification makes mistakes. Sampling and periodic review therefore belong in the operating routine, and the canonical store must stay readable by people.
Conclusion
Durable knowledge lives in files a person can read and correct. Semantic memory is an index over those files and holds no truth of its own. Every write records provenance, resolves conflicts explicitly and filters sensitive data before anything persists.
Agents with this structure can still be wrong, but their errors are traceable to a note, a source and a decision. That makes them fixable.
Quand le monitoring semble cassé : une méthode forensique pour diagnostiquer sans aggraver
Un dashboard vide produit une réaction presque automatique : redémarrer le service, relancer les agents, réinitialiser la configuration ou modifier les permissions.
C’est souvent le mauvais premier geste.
Un écran sans données ne signifie pas nécessairement que les données ont disparu. Il peut signaler un problème d’URL, une interface frontend qui ne charge pas ses ressources, une session utilisateur incomplète, une règle de visibilité trop restrictive ou une chaîne de collecte partiellement rompue.
Dans un environnement auto-hébergé, ces couches se ressemblent suffisamment pour provoquer de faux diagnostics. Un service peut répondre correctement alors que son interface affiche une erreur. Une API peut être saine alors que le navigateur pointe vers une adresse obsolète. Les agents peuvent continuer à collecter des métriques alors qu’un compte n’a plus le droit de les voir.
La bonne approche consiste à traiter le dashboard comme un symptôme, puis à remonter la chaîne sans modifier la production tant que les faits ne sont pas établis.
Le modèle mental : séparer les couches
Pour éviter les conclusions hâtives, je découpe le problème en couches indépendantes :
- Le service : le processus répond-il et son port est-il accessible ?
- L’URL et le proxy : le navigateur atteint-il le bon point d’entrée ?
- L’API : les endpoints renvoient-ils des réponses cohérentes ?
- Les agents : la collecte continue-t-elle réellement ?
- La base ou le stockage : les données existent-elles encore ?
- La session : le navigateur utilise-t-il une session valide ?
- Les permissions : le compte courant a-t-il le droit de consulter ces données ?
- Le frontend : l’interface affiche-t-elle correctement une réponse pourtant valide ?
Cette liste est volontairement prosaïque. Elle empêche de confondre un symptôme visible avec sa cause.
1. Commencer par une observation en lecture seule
La première question n’est pas « qu’est-ce que je peux redémarrer ? », mais :
Quelle partie de la chaîne est réellement cassée ?
Je commence par relever le symptôme exact : écran vide, erreur JavaScript, réponse HTTP inattendue, absence d’un seul hôte, historique tronqué ou données visibles pour un compte mais pas pour un autre.
Je note aussi ce qui fonctionne encore. Un service accessible depuis une autre page, une métrique récente dans une autre vue ou une réponse API correcte sont des points d’ancrage précieux.
Cette discipline paraît lente, mais elle réduit le risque de transformer un problème d’affichage en incident de production.
2. Vérifier le service avant de toucher à la configuration
Un contrôle de santé minimal permet de répondre à quelques questions factuelles :
- le processus est-il actif ?
- le port écoute-t-il ?
- une requête locale obtient-elle une réponse ?
- les logs récents montrent-ils une erreur de démarrage ou seulement une erreur de requête ?
Il faut distinguer « le service est arrêté » de « le service répond mais l’interface ne l’exploite pas ». Dans le premier cas, l’investigation porte sur le runtime et le déploiement. Dans le second, redémarrer ne fera que masquer temporairement le problème.
À ce stade, je privilégie les vérifications non destructives : état du processus, statut du conteneur, test HTTP, lecture des logs et inspection de la configuration existante.
3. Vérifier l’URL réellement utilisée par le navigateur
Les applications de monitoring sont souvent composées de plusieurs adresses : URL publique, endpoint d’API, adresse interne entre conteneurs et URL annoncée aux agents.
Une interface peut donc se charger depuis la bonne adresse tout en essayant ensuite d’appeler une API qui n’est plus valide. Le résultat côté utilisateur ressemble à un dashboard cassé, alors que le backend est parfaitement vivant.
Il faut vérifier :
- l’URL de base configurée dans l’application ;
- les chemins d’API demandés par le frontend ;
- les redirections du proxy inverse ;
- les erreurs de type CORS, 404, 401 ou 403 dans le navigateur ;
- les différences entre accès direct et accès via le proxy.
Le code HTTP est déjà un indice. Une erreur 401 oriente vers la session ou l’authentification. Une 403 suggère plutôt une permission. Une 404 peut révéler une mauvaise base d’URL. Une réponse 200 avec un contenu vide déplace l’attention vers les filtres, les données ou le frontend.
4. Tester l’API indépendamment du frontend
Le frontend ajoute une couche de complexité inutile pour le diagnostic. Je teste donc les endpoints directement, avec la même session si nécessaire.
L’objectif est de déterminer si l’API renvoie :
- les données attendues ;
- une liste vide mais valide ;
- une erreur d’authentification ;
- une erreur de permission ;
- une réponse lente ou interrompue ;
- un schéma différent de celui attendu par l’interface.
Cette étape permet de séparer deux classes de problèmes souvent confondues : « aucune donnée n’existe » et « l’interface ne sait pas afficher la donnée reçue ».
Un dashboard qui ne montre rien n’est donc pas une preuve d’absence. C’est une preuve qu’il faut regarder la réponse qui se trouve derrière.
5. Vérifier les agents sans les relancer
Quand des métriques manquent, la tentation est de redémarrer tous les agents. Avant cela, je vérifie leur dernier contact, leur état et les erreurs de collecte.
Quelques questions utiles :
- les agents envoient-ils encore des données ?
- leur horodatage évolue-t-il ?
- le problème concerne-t-il tous les agents ou un sous-ensemble ?
- la collecte échoue-t-elle côté agent, côté réseau ou côté serveur ?
- les données sont-elles présentes mais filtrées dans l’interface ?
Cette distinction est importante. Un agent silencieux n’a pas le même diagnostic qu’un agent actif dont les métriques sont masquées. Dans le premier cas, il faut chercher un problème de connectivité, de configuration ou de runtime. Dans le second, relancer l’agent est une opération inutile et potentiellement perturbatrice.
6. Confirmer l’état de la base et du stockage
Si l’API répond mais que les séries sont vides, je vérifie ensuite la couche de persistance.
La question n’est pas seulement « la base est-elle démarrée ? », mais aussi :
- contient-elle encore les enregistrements attendus ?
- les écritures récentes arrivent-elles ?
- une migration ou un changement de schéma a-t-il modifié la lecture ?
- l’application consulte-t-elle le bon volume ou la bonne base ?
- les permissions du processus permettent-elles la lecture ?
Là encore, il faut éviter les remèdes irréversibles. Ne pas supprimer un volume, recréer une base ou réinitialiser un utilisateur avant d’avoir démontré que les données sont absentes et restaurables.
Dans un incident de monitoring, la préservation des preuves vaut souvent plus qu’une restauration précipitée.
7. Examiner la session et le compte courant
Une session périmée peut produire un écran trompeur. Le navigateur conserve parfois une interface partiellement chargée, tandis que les requêtes suivantes sont refusées ou exécutées avec un utilisateur différent de celui imaginé.
Je vérifie donc :
- l’identité effectivement associée à la session ;
- l’expiration des cookies ou jetons ;
- la présence d’une redirection vers la connexion ;
- le comportement en navigation privée ;
- la différence entre deux comptes disposant de rôles distincts.
Ce test est particulièrement utile quand un autre utilisateur voit les données ou quand l’API fonctionne avec une authentification explicite mais pas depuis le navigateur.
Un problème de session n’appelle pas nécessairement une modification de la configuration du service. Il peut se résoudre par une reconnexion contrôlée, après avoir confirmé que les données et les permissions sont intactes.
8. Contrôler les règles de visibilité
Les systèmes modernes séparent souvent l’existence d’une donnée et le droit de l’afficher. Les filtres peuvent venir du rôle utilisateur, d’un périmètre d’équipe, d’un dossier, d’un tag, d’un tenant ou d’une règle d’accès héritée.
Je compare, si c’est possible, une même requête avec deux profils autorisés à des périmètres différents. Cette comparaison est plus informative qu’une modification immédiate des permissions.
Il faut aussi rechercher les filtres silencieux : période sélectionnée, environnement, hôte, statut, étiquette ou dossier. Un filtre conservé dans l’URL ou dans le stockage local peut donner l’impression que toutes les données ont disparu.
9. Lire le frontend comme un système distribué
Le navigateur n’est pas une simple fenêtre sur le serveur. C’est un composant qui possède son cache, sa session, ses appels réseau, ses erreurs d’exécution et sa logique de rendu.
Les outils de développement donnent des indices concrets :
- console : exceptions JavaScript et erreurs de parsing ;
- réseau : endpoints appelés, codes HTTP, temps de réponse et réponses ;
- stockage : cookies, local storage et préférences persistées ;
- ressources : fichiers JavaScript ou CSS manquants ;
- comparaison : navigation privée, autre navigateur ou autre compte.
Une erreur frontend peut apparaître après un changement de version alors que l’API n’a pas changé. À l’inverse, une API modifiée peut laisser l’interface se charger avant d’échouer au moment du rendu.
Le symptôme « page blanche » doit donc être traité comme un incident distribué, pas comme une preuve contre le service de données.
Une séquence de diagnostic réutilisable
Voici la séquence que je retiens pour ce type d’incident :
- Capturer le symptôme exact et ce qui fonctionne encore.
- Vérifier le processus, le port et une réponse locale.
- Vérifier l’URL publique, le proxy et les redirections.
- Tester l’API directement.
- Vérifier l’activité des agents sans les relancer.
- Confirmer la présence et l’accessibilité des données persistées.
- Contrôler la session et l’identité effective.
- Comparer les permissions et les filtres de visibilité.
- Lire les erreurs frontend et le trafic réseau.
- Corriger uniquement la couche dont la cause est démontrée.
- Rejouer les vérifications initiales et documenter le résultat.
Cette séquence n’est pas un dogme. Elle a une propriété utile : elle progresse du plus observable au plus contextuel, tout en limitant les changements qui pourraient brouiller l’enquête.
La correction minimale est souvent la meilleure
Une fois la cause identifiée, la correction doit rester proportionnée. Cela peut être une URL corrigée, une reconnexion, une permission ajustée, un filtre supprimé ou une incompatibilité frontend résolue.
Il n’est pas nécessaire de reconstruire le service, de réinitialiser la base ou de réinstaller les agents si la chaîne de données est intacte.
La qualité d’une intervention opérationnelle ne se mesure pas au nombre de commandes exécutées. Elle se mesure à la précision du diagnostic, à la conservation des données et à la capacité de revenir à un état vérifiable.
Ce que je retiens
Un monitoring qui semble cassé peut être un problème d’observabilité de l’observabilité. Le dashboard ne montre qu’une représentation finale d’une chaîne composée de services, d’URL, d’API, d’agents, de stockage, de sessions, de permissions et de code frontend.
La méthode fiable consiste à décomposer cette chaîne, vérifier chaque couche en lecture seule, conserver les preuves et ne modifier que ce qui est nécessaire.
Ce réflexe est transférable bien au-delà du monitoring. Il s’applique à presque toute interface auto-hébergée qui transforme un symptôme visuel en diagnostic technique.
Si un écran vide vous donne envie de tout redémarrer, commencez par une question plus utile : quelle couche ai-je réellement prouvée défaillante ?
Cet article est volontairement anonymisé. Les noms de services, hôtes, adresses, comptes et détails d’infrastructure ont été retirés ou généralisés.
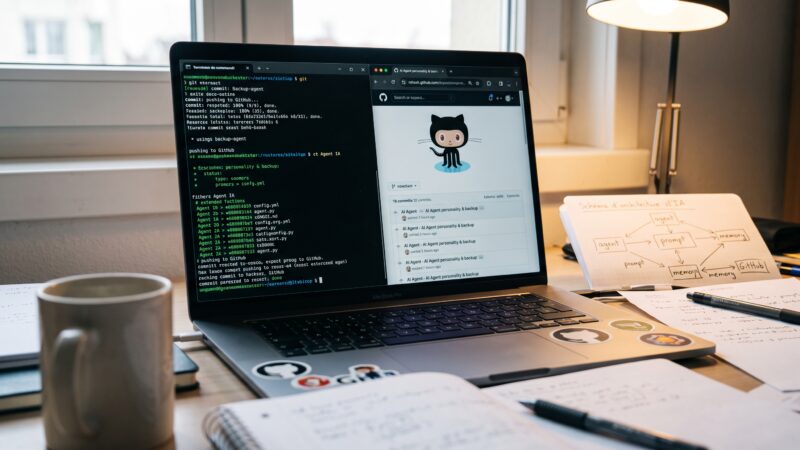
How to Back Up Your Personalized AI Agent to GitHub
The more you use an AI agent, the more valuable it becomes. You customize its personality, add skills, teach it how you work, and build up memory and context. If the machine running it fails, rebuilding all of that from scratch would be painful.
A practical safety net is to back up the files that make your agent personal into a private GitHub repository — while carefully keeping secrets, tokens, and credentials out of it.
🗂️ What to back up
The goal is simple: (your personalized agent) − (generic install) − (secrets). Concretely, that usually means:
Configuration files
Model, provider, personality, terminal preferences, and other agent-level settings.
Personality / instructions
The role, tone, and rules that define how your agent behaves and responds.
Memory files
Long-term context and preferences — review carefully for personal info first.
Scheduled tasks
Cron jobs and recurring automations that are easy to forget during a rebuild.
Custom skills
Scripts and workflows you created or modified for your specific needs.
Never include
Secrets, tokens, credentials — these must never go into the repo.
🚫 What never belongs in the repo
.env files
🚀 The backup workflow
agent config set GITHUB_TOKEN <your-token>
💭 Final thoughts
A personalized AI agent becomes hard to replace once it holds your settings, memory, and workflows. A clean private GitHub backup gives you a restore path when hardware fails or you migrate machines — without turning GitHub into a secrets manager.
Inspired by a guide from Zawanah about backing up a Hermes agent to GitHub.
Obsidian et ontologies pour des workflows LLM efficaces
Comment utiliser Obsidian comme base de connaissances structurée et des ontologies pour améliorer la récupération, le prompting et la cohérence des grands modèles de langage — outils, templates et exemples opérationnels.
Obsidian peut dépasser le rôle de simple carnet : bien structuré, il devient le noyau d’un workflow RAG fiable. Ce guide présente, de façon pragmatique, pourquoi une ontologie réduit les hallucinations, comment la traduire dans Obsidian et quels paramètres tester pour un mécanisme de récupération robuste. Vous trouverez des templates YAML, des requêtes Dataview, et une checklist de déploiement.

Les ontologies expliquées et pourquoi elles réduisent les hallucinations
Si vous voulez que vos workflows LLM cessent d’inventer des faits, structurez votre connaissance. Une ontologie pragmatique — entités, relations, propriétés — impose des types et des contraintes qui réduisent le bruit lexical et les sauts inferentiels du modèle.
Définition rapide
Une ontologie est un schéma déclaratif : entités (p.ex. Projet, Tâche), relations (dépend_de, responsable_de) et propriétés (statut, échéance). Elle sert de filtre pour la récupération (metadata‑filtering) et comme guide pour composer des prompts factuels.
Exemple pratique et impact mesurable
Minimal : entités = Projet, Tâche, Ressource ; relations = dépend_de, responsable_de ; propriétés = statut, priorité, échéance. Dans un pilote RAG de 200 requêtes internes, l’utilisation d’un filtrage ontologique a fait passer la précision d’extraits pertinents d’environ 62% à ~86–90% (top_k=3). Le mécanisme : on limite les candidates par type/relations, donc le LLM a moins d’hypothèses à combler.
| Structure libre (notes) | Métadonnées frontmatter | Ontologie déclarative |
|---|---|---|
| Précision : faible (≈50–70%) | Précision : moyenne (≈70–80%) | Précision : élevée (≈85–95%) |
| Réutilisabilité : limitée | Réutilisabilité : bonne (recherche + tags) | Réutilisabilité : excellente (requêtes typées, RAG) |
| Coût maintenance : faible initialement, chaos à long terme | Coût maintenance : modéré | Coût maintenance : élevé (annotation, gouvernance) |
Coûts, limites et signaux d’échec
L’effort initial porte sur l’annotation, les règles de nommage et la validation métier. Démarrez avec ~10 entités et ~20 relations, puis itérez après 4–6 semaines. Signaux d’alerte : perte de précision >10 pts, échéances contradictoires, ou multiples assertions incompatibles pour la même entité. Ne complexifiez pas l’ontologie trop tôt — restez pragmatique.

Mettre en place une ontologie dans Obsidian — guide pas à pas
Étapes pragmatiques
Commencez petit et reproductible : choisissez un dossier racine (ex. /Projects), créez un Ontology Index listant types et relations, puis standardisez un template YAML pour chaque type. Activez Templates (core) ou Templater pour insérer automatiquement le frontmatter, et Dataview pour interroger ces métadonnées. Testez avec 100–500 fiches avant d’étendre.
Template YAML frontmatter (exemple)
---
type: Projet
status: active
owner: "Claire Dupont"
date: 2026-09-01
tags: [migration, Q4]
relations:
depends_on: ["Projet Beta"]
responsible_for: ["Tâche 123", "Tâche 124"]
---
Exemple Dataview — lister tâches dépendantes
TABLE status, owner, file.link as task
FROM "Tâches"
WHERE type = "Tâche" AND contains(relations.depends_on, "Projet Alpha")
SORT date asc
Prompt RAG (template opérationnel)
System: You are a helpful assistant. Use up to top_k=5 sources (chunk_size≈500 tokens), prioritize owner and date.
Context (from retrieved sources):
- Title: {{title}} | type: {{type}} | owner: {{owner}} | date: {{date}} | excerpt: {{excerpt(200)}}
User question: {{user_query}}
Answer strictly from context; if missing, say you don't know.
Paramètres et automations recommandés
Configurez Templates/Templater pour créer rapidement des notes normalisées. Activez Dataview + MetaEdit pour manipuler le frontmatter sans ouvrir chaque note. Règles pratiques : chunk_size ≈ 500 tokens, top_k 4–8 pour support, versionnez le modèle d’embeddings et stockez la métadonnée de génération.
Checklist de déploiement (priorités)
- Définir 10 entités clés et 20 relations fréquentes (Priorité haute)
- Créer templates YAML pour chaque type (Priorité haute)
- Configurer Templates/Templater et Dataview (Priorité moyenne)
- Indexer 100–500 notes pilote et mesurer précision (Priorité moyenne)
- Former 1–2 utilisateurs métiers pour validation (Priorité haute)
- Évaluer besoin d’une vector DB externe selon volume (Priorité basse)
Intégrations et quand externaliser la vector DB
Embeddings : OpenAI pour prototypage rapide, Hugging Face pour open models. Vector DBs : Pinecone, Weaviate, Milvus en production. Règle simple : restez local si <50k vecteurs et usage mono‑utilisateur ; externalisez si vous prévoyez >100k vecteurs, usages concurrents ou besoins HA/replication.

Workflows opérationnels recommandés
RAG temps réel pour support client
Flux : ingestion → embeddings → retrieval → prompt template → post‑filtering. Paramètres concrets : chunk_size 500–1 000 tokens, upsert batch 32–128, top_k 5–8, embedding model type 1 536–3 072 dims. Latence cible retrieval <200 ms. Contremesures aux risques : versionnez les fiches (frontmatter updated_at), réindexation incrémentale 6–24 h pour contenu majeur, et human‑in‑loop sur réponses « doute ».
Pipeline batch pour synthèse de veille
Flux : scraping → nettoyage OCR/NER → classification → stockage atomique dans Obsidian → génération de résumés. Paramètres : batch scraping 500–2 000 pages, chunk_size 400–600, top_k 10 pour synthèse. Déduplication par hash + seuil de similarité (cosine ≥ 0.95) avant upsert.
Étude de cas condensée — startup SaaS (imaginaire)
Situation : 50 employés, 2 000 tickets/mois, 600 récurrents. Actions : ontologie produit (≈60 types), 2 000 fiches, embeddings OpenAI, top_k 5, post‑filtering par date/owner, rerank cross‑encoder. Résultats en 3 mois : tickets récurrents −30%, temps moyen résolution −22% (45 → 35 min), économie ≈ 110–120 heures support/mois. Coût prototype : embeddings + vectordb ≈ 800–1 200 €/mois ; ROI projeté 3–6 mois selon adoption.
Opinion : Les ontologies ne sont pas une panacée, mais elles transforment la base documentaire en référentiel interrogeable et auditables. Le véritable levier est la discipline opérationnelle : gouvernance, réindexation et indicateurs (précision RAG, temps de résolution) pour mesurer le retour.
Conclusion
Structurer l’information dans Obsidian avec une ontologie claire change la relation entre vos données et les LLM : on passe d’une saisie brute à un référentiel interrogeable et explicable. Les gains sont concrets — meilleures réponses, moins d’hallucinations, réutilisabilité — mais ils exigent modélisation et discipline technique (embeddings, chunking, plugins). Adoptez une approche itérative : commencer simple, mesurer, enrichir l’ontologie et automatiser les mises à jour.
Tarification à l’usage et économie des tokens IA, vers un nouveau paradigme pour l’intelligence artificielle API
Comment la facturation par token redéfinit l’accès, le coût et la stratégie des API d’intelligence artificielle
L’intelligence artificielle bascule vers un nouveau modèle économique : l’API à la demande, tarifiée au token. Que l’on choisisse OpenAI, Anthropic, Google, Mistral ou l’on expérimente des plateformes d’agrégation comme OpenRouter, la tarification au token applique au monde de l’IA les recettes qui ont fait le succès du cloud. Ce nouveau standard bouleverse en profondeur la façon dont développeurs, entreprises et décideurs conçoivent l’accès à l’intelligence artificielle : flexibilité accrue, paiement à l’usage, choix concurrentiels, mais aussi nouveaux risques. Décryptage des mécanismes, atouts et challenges du paradigme « API IA », où chaque token devient décision stratégique.

Du logiciel à l’API IA : naissance d’une nouvelle infrastructure
De la licence logicielle au cloud : une rupture définitive
L’histoire du numérique a été marquée par trois modèles dominants en vingt ans : la licence perpétuelle (logiciel sur site, paiement unique), l’SaaS avec abonnement, puis le cloud à la consommation. Désormais, l’intelligence artificielle ouvre une quatrième ère : celle de l’API IA facturée à l’usage, au token, qui combine la puissance du cloud et la flexibilité d’interfaces programmables.
| Modèle | Accès | Facturation | Infrastructure | Exemples |
|---|---|---|---|---|
| Licence perpétuelle | Sur site | Unique/annuelle | Serveurs internes | Microsoft Office, Photoshop |
| SaaS | En ligne | Abonnement | Cloud fournisseur | Salesforce, Slack |
| API IA par token | Programmable à la demande | À l’usage (token) | IA mutualisée cloud | OpenAI, Google Vertex AI, Mistral, Anthropic, xAI |
API IA : simplicité d’intégration, usage ajusté
L’API d’intelligence artificielle révolutionne l’accès aux LLM avancés : plus besoin de déployer ni gérer d’infrastructure lourde. Un endpoint, une clé d’authentification : en quelques minutes, l’IA enrichit une app, un chatbot, une plateforme métier.
La facturation « à la consommation » par token garantit une maîtrise immédiate des coûts : seul l’usage réel compte. Cette granularité s’accompagne de :
- Flexibilité : choix dynamique du modèle selon la tâche ou le budget.
- Implémentation rapide : ajout d’intelligence sans dettes techniques majeures.
- Mutualisation : partage des ressources sur un cloud opérant à très grande échelle.
- Évolutivité automatique : support de la montée en charge du service, sans anticipation matérielle.
« L’intelligence artificielle devient l’infrastructure invisible, comme l’électricité ou l’eau, mais à la granularité du token. »
Marché des API IA : une compétition accélérée par la standardisation
La généralisation de l’API IA par token stimule l’émergence d’un écosystème ultra-concurrentiel : OpenAI (ChatGPT, GPT-4), Anthropic (Claude 3), Google (Gemini, Vertex AI), Mistral (Fast, Large via OpenRouter), xAI (Grok)… Chacun propose désormais des APIs taillées pour la sélection à la demande, tandis que des plateformes multi-fournisseurs (OpenRouter, Together AI) permettent de combiner, comparer ou basculer de l’un à l’autre sans friction technique.
Pour les entreprises, cette standardisation réduit le verrouillage technique et accélère l’expérimentation. Toutefois, l’agilité offerte par la logique du token implique une vigilance accrue : suivi des coûts en temps réel, gestion des quotas, dépendance au réseau et à la qualité des services sous-jacents — autant de nouveaux leviers stratégiques.

Tarification au token : révolution des coûts et des usages
Unité de facturation : précision, prédictibilité et passage à l’échelle
La facturation à l’usage par token inscrit l’IA dans la lignée du « pay as you go » du cloud, avec une granularité extrême. Un token (environ 0,75 mot) devient la brique monétaire minimale de chaque appel API. Cela rend possible une mesure précise des coûts, adaptée du particulier à la multinationale.
- Paiement instantané et sans engagement : chaque prompt, chaque réponse, chaque pipeline a un coût lisible.
- Montée en charge fluide : du proof of concept à l’application grand public, la structure de coût suit l’usage effectif.
- Pression concurrentielle à la baisse : la compétition entre fournisseurs entraîne régulièrement une réduction du prix par token et encourage l’apparition d’alternatives (API open source, modèles auto-hébergés, etc.).
Comparatif : tarifs publics 2024 des principaux acteurs
| Fournisseur / Modèle | Entrée (1k tokens) |
Sortie (1k tokens) |
|---|---|---|
| OpenAI GPT-4o | 0,005 $ | 0,015 $ |
| Mistral Large | 0,008 $ | 0,024 $ |
| Anthropic Claude 3 Sonnet | 0,003 $ | 0,015 $ |
| Google Gemini 1.5 Pro | 0,0025 $ | 0,0025 $ |
| OpenRouter/agrégateurs | Selon modèle sous-jacent | |
Exemple concret : 10 000 requêtes/an avec 3 000 tokens par interaction coûtent ~900 $ sur GPT-4o, mais pourraient descendre à 120 $ avec un modèle interne Mistral Small.
Checklist : optimiser ses usages IA API au token
- Suivre en temps réel la consommation par type de prompt ou projet.
- Définir des plafonds de coûts mensuels ou par client.
- Rédiger des prompts compacts pour éviter l’explosion tarifaire liée à la verbosité.
- Comparer régulièrement les fournisseurs pour profiter de la guerre des prix.
- Automatiser l’alerting sur les dérives de consommation.
Avantages majeurs pour tous les profils métiers
- Innovation accessible : barrieres d’entrée basses, prototypage instantané.
- Évolutivité native : même modèle économique pour 10 ou 100 000 utilisateurs.
- Pas de gestion matérielle : ni serveurs, ni GPUs à anticiper.
- Mobilité contractuelle : migration ou diversification via APIs compatibles.
- Alignement immédiat coût/usage : dépenses proportionnelles à la valeur générée.
Limites et défis concrets
- Difficulté d’anticipation sur les usages massifs ou chaotiques.
- Nécessite une optimisation fine des prompts pour contenir la facture.
- Risque de « spike » (pics de charges), quotas imprévus, et interruptions de service si limites atteintes.

Risques et limites de l’économie des tokens IA
Dépendance aux fournisseurs et verrouillage technologique
L’économie du token propulse les Goliaths technologiques (OpenAI, Google, Anthropic, xAI…) au centre du jeu. Si l’API promet l’agilité, elle peut induire un lock-in propriétaire : migration coûteuse, arrêt soudain d’un modèle ou hausse imprévisible des prix sont des risques réels. Hausse tarifaire brutale de GPT-4 en 2023 : de nombreuses startups ont été contraintes d’adapter leur stratégie ou de choisir des alternatives parfois moins performantes.
Volatilité des coûts et gouvernance des budgets
À l’usage massif, la facture API IA peut s’envoler et révéler une grande instabilité financière. Des changements tarifaires soudains ou une demande fluctuante rendent la planification difficile. Comme le souligne un CTO :
« Au-delà du million de tokens par jour, notre facture API varie parfois du simple au double selon la semaine. »
Enjeux de confidentialité et concentration du marché
Envoyer des données à des API externes soulève des doutes sur la confidentialité et la traçabilité. Pour les secteurs régulés (droit, santé…), des choix alternatifs émergent : modèles open source comme Mistral ou Llama, auto-hébergement, solutions de chiffrement avancé.
Tableau de synthèse : cartographie des principaux risques
| Risque | Mécanisme | Alternatives/Pistes |
|---|---|---|
| Dépendance fournisseur | API fermées, modèles exclusifs | Open source : Mistral, Llama |
| Volatilité prix | Tarifs variables, quotas changeants | Plafonds, contractualisation long-terme |
| Confidentialité | Transit de données externes | Modèles auto-hébergés, chiffrement |
| Concentration du marché | Peu d’acteurs dominants | Plateformes multi-providers (OpenRouter) |
Face à ces risques, de nombreux professionnels privilégient une stratégie hybride : routage dynamique multi-fournisseurs et recours à des modèles locaux ou open source pour sécuriser la chaîne de valeur.

Agents intelligents et avenir API : entre diversité et concentration
L’ère des agents IA multi-modèles
L’automatisation et l’orchestration intelligente de l’accès aux API IA posent les bases d’un nouveau meta-marché. Des agents IA désormais capables de router dynamiquement les requêtes vers différents modèles selon le coût, la qualité ou les exigences réglementaires. Des plateformes comme OpenRouter ou PromptLayer offrent un accès unifié aux moteurs d’OpenAI, Anthropic, Mistral ou Google Gemini, et permettent d’associer souplesse, contrôle budgétaire et gain de temps.
Checklist stratégique : tirer profit de la diversité IA API
- Flexibilité : router en temps réel sur le modèle le plus pertinent (performance, prix, conformité).
- Suivi centralisé des coûts : analytiques intégrées, plafonds, alertes de consommation.
- A/B testing instantané : expérimentation simplifiée sur les modèles concurrents.
- Réduction du lock-in technique : migration et agrégation de fournisseurs en un clic.
« L’agent IA devient l’équivalent du load balancer pour l’IA : il module dynamiquement les ressources, libérant les développeurs de la rigidité des choix d’infrastructure. »
De la diversité à la concentration : nouveau verrouillage ?
Si l’aggrégation multi-modèles vise à réduire la dépendance, elle concentre le pouvoir entre les mains de quelques plateformes d’orchestration. Ces intermédiaires-clés, capables à terme d’imposer leurs propres règles ou surcoûts, peuvent constituer un pivot stratégique autant qu’une nouvelle source de verrouillage.
| Avantages | Risques |
|---|---|
| Indépendance vis-à-vis d’un seul fournisseur | Capture possible du marché par quelques orchestrateurs |
| Adoption rapide des innovations IA | Imposition de règles tarifaires ou techniques |
| Comparaison transparente du coût par token | Concentration accrue sur l’accès centralisé |
La diversité offerte par ces solutions est un moteur d’innovation, mais appelle à une veille stratégique permanente : garantir la souveraineté sur ses flux de données, maintenir la maîtrise budgétaire, anticiper les effets de concentration du marché.
Conclusion
La tarification à l’usage par token redéfinit l’économie de l’IA, remplaçant la licence ou l’abonnement par le calcul à l’interaction. Ce nouveau paradigme, tout en apportant agilité, mutualisation et ouverture, exige rigueur et stratégie dans la gestion des coûts, le choix des partenaires et la maîtrise de la confidentialité. L’économie des tokens façonnera la décennie à venir, autant source d’opportunités que de nouveaux équilibres à inventer entre diversité, indépendance et efficacité.
What I Can Do For You
Data Science
Unlocking insights and driving business growth through data analysis and visualization as a freelance data scientist.
Data Analysis
Helping businesses make informed decisions through insightful data analysis as a freelance data analyst.
Website Development
Bringing your online presence to life with customized website development solutions as a freelance developer.
Home Automation
Transforming your living space into a smart home with custom home automation solutions as a freelance home automation expert.
Docker & Server
Optimizing your software development and deployment with Docker and server management as a freelance expert
Consultancy
Identification of scope, assessment of feasibility, cleaning and preparation of data, selection of tools and algorithms.
My Portfolio
My Resume
Education
Msc Data Science And Artificial Intelligence
2022 - 2023Training in data science & artificial intelligence methods, emphasizing mathematical and computer science perspectives.
Master In Management
EDHEC Business School (2005 - 2009)English Track Program - Major in Entrepreneurship.
BSc in Applied Mathematics and Social Sciences
University Paris 7 Denis Diderot (2006)General university studies with a focus on applied mathematics and social sciences.
Education
Higher School Preparatory Classes
Lycée Jacques Decour - Paris (2002 - 2004)Classe préparatoire aux Grandes Écoles de Commerce. Science path.
Scientific Baccalaureate
1999 - 2002Mathematics Major
Data Science
Python
SQL
Machine learning libraries
Data visualization tools
DESIGBig Data (Spark, Hive)
Data Analysis
Spreadsheet software
Data visualization tools (Tableau, PowerBI, and Matplotlib)
Statistical software (SAS, SPSS)
SAP Business Objects
Database management systems (SQL, MySQL)
Development
HTML
CSS
JAVASCRIPT
SOFTWARE
Version Control Systems
MLOps
CI/CD
Docker and Kubernetes
AutoML
Model serving frameworks
Prometheus, Grafana
Job Experience
Data Engineer / Data Scientist - Managing Director (Alphaprime)
(2024 - Present)NLP tools (chatbots, LLM, LangChain), Fine-tuning and prompt engineering, Data wrangling (Alteryx) and data visualization (Tableau, Power BI), Dynamic dashboards with Streamlit, Gradio, Dash, Computer vision (anomaly detection, video stream analysis), MLOps deployments (Docker, Google Cloud, Azure, AWS)
Data Engineer (Ofi Invest Asset Management)
(Dec 2023 - Apr 2024)Data transformation with Cloud Dataprep (Trifacta & Alteryx), 70% reduction in ETL pipeline run time by optimizing Airflow DAGs, Data warehouse on Google Cloud Platform, Data acceptance and regression testing with BigQuery, Quality monitoring with Tableau and Colab notebooks
Consulting, Automation and Security
(2019 - 2021)Implementation of automated reporting tools via SAP Business Objects, Processing and securing sensitive data (data wrangling, encryption, redundancy), Remote monitoring management solutions via connected objects (IoT) and image processing, Internal pentesting and network security consulting, VPN implementation, Outsourcing of servers
Consulting, E-commerce and Digital Marketing
(2017 - 2019)Consulting in e-commerce and digital marketing (Bangkok area), Booking.com, Airbnb, Agoda online booking management for third parties, SEO in the hotel industry.
Consulting, internal company network
(2016 - 2017)Implementation of corporate networks and virtualization solutions (rack cabling, firewalls, proxmox virtualization), Management of firewalls and internal networks. (pfSense)
Entrepreneurship Experience
Founder, web developer
(2009 - 2017)Programming and maintenance of websites and web applications, Consulting in digitalization and process optimization for local SMEs, Implementation of turnkey e-commerce solutions.
High-end property management (JM Gestion)
(2013 - 2016)Rental management of a property portfolio for short-term tourist rentals in Paris and supervision of renovation works, Apartment sourcing for foreign buyers, high-end real estate investment advice (>€1M)
Corporate Banking
Assistant Fund Manager
Credit Portfolio Management - CALYON - 2008 - 2009● Preparation of committee notes for new ABS/CDO credit derivative investments ● Calculation and measurement of portfolio risk (Value-at-Risk, exotic and vanilla ABS, SWAP, liquidity lines) ● Daily monitoring of credit derivatives portfolio structures (Mark-to-Market, P&L, re-financing) ● Design of risk measurement and decision support tools in VBA.
Credit Risk Analyst
Risk and Controls Department – NATIXIS – Paris – 2008Study of financing files for review by the credit committee (structured finance, commodity trade finance, and car manufacturers) ● Financial analysis, rating, and credit risk analysis of a portfolio of companies ● Financing files studied: from €1m to €1000m
Retail Banking
Assistant Business Account Manager
BNP Paribas - 2006● Writing reports on business plans for small SMEs ● Risk and feasibility Analysis and Decision making ● Negotiation of financing xpackages with applicants
Pierre Toul
Chief Technical OfficerData & Process Automation
Jan. 2025 – Sep. 2025Mehdi a su rapidement comprendre nos processus métiers et transformer des outils Excel/VBA existants en solutions Python plus robustes et maintenables. Son autonomie, sa rigueur et son attention portée aux utilisateurs ont facilité l'intégration et l'adoption des nouveaux outils.
Arkadus Romitry
Engineering Data LeadData Engineering & Analytics
Sep. 2024 – Jan. 2025Mehdi a mené une analyse complexe sur plusieurs années de données techniques et a su en extraire des tendances utiles aux équipes métier. Il combine efficacement maîtrise technique, rigueur analytique et capacité à restituer des résultats complexes de manière claire.
Contact Me
Mehdi Fekih
Data Scientist.I am available for freelance work. Connect with me via this contact form or feel free to send me an email.
Phone: +33 (0) 7 82 90 60 71 Email: [email protected]